跳到主要内容GPT-5.6和5.5、5.4有什么区别?按任务、速度与成本选模型
比较GPT-5.6、GPT-5.5和GPT-5.4的模型定位、适用任务与评测方法,区分模型、推理强度和订阅套餐,避免照搬旧价格或跑分。
比较 GPT-5.6、5.5 和 5.4,不能只把版本号排个大小。GPT-5.6 分为 Sol、Terra、Luna;旧模型也各有适用范围。一次任务还受推理强度、工具、提示和文件质量影响,同一个版本可能跑出很不一样的结果。
这篇讨论三个家族的选择方法。2026 年 9 月已有 GPT-6 Astra,GPT-5.6 不再是“最新型号”的同义词;已有工作流仍可以按效果、速度和预算评估是否继续使用。
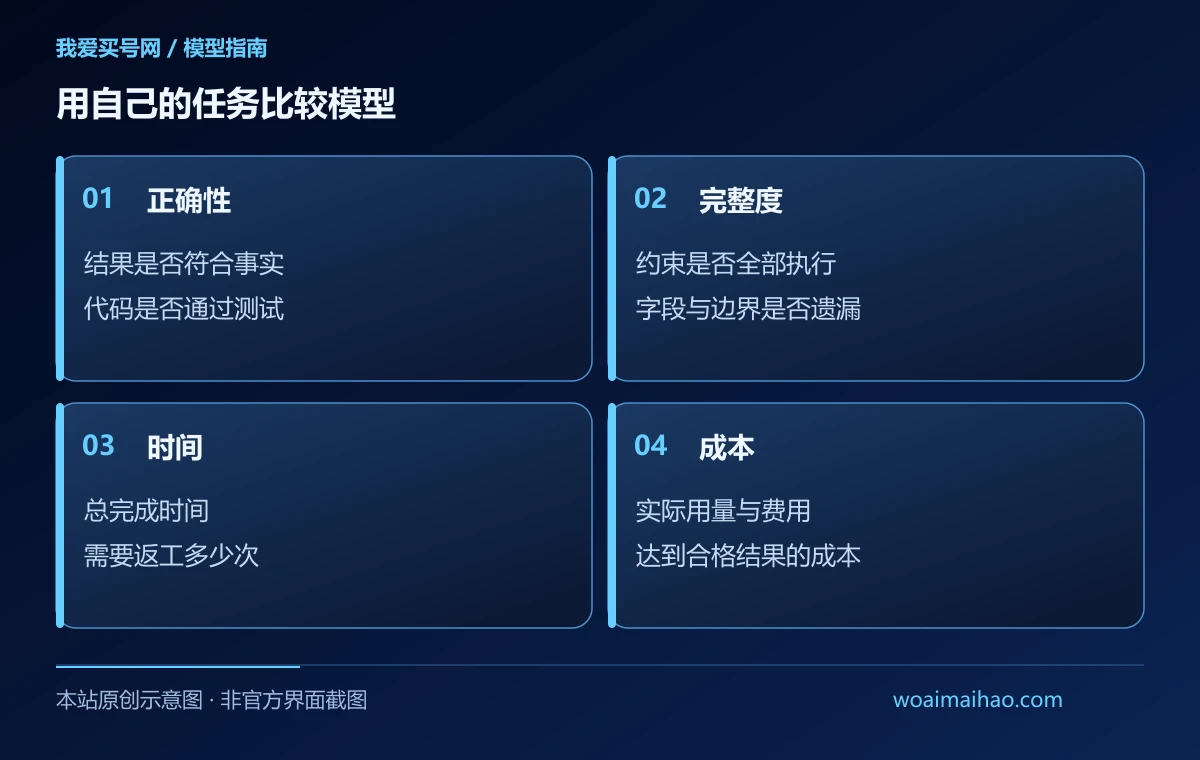 用自己的任务比较模型(本站原创示意图)
版本号和模型档位分别看
| 比较对象 | 需要理解的区别 | 适合怎样评估 |
|---|
| GPT-5.6 Sol | 5.6 家族面向复杂工作的档位 | 复杂分析、编码与工具任务 |
| GPT-5.6 Terra | 兼顾能力与成本 | 日常专业任务能否以较低成本完成 |
| GPT-5.6 Luna | 面向高频、成本敏感任务 | 分类和提取能否稳定达标 |
|
GPT-5.5
| GPT-5.4 | 更早的专业工作模型 | 旧系统回归与仍受支持的调用场景 |
API 中的 GPT-5.5 模型与历史聊天界面的“GPT-5.5 Instant”不能不加区分地写成同一项。比较时记录完整模型名称,避免拿一次 Instant 回答对照另一次高强度推理,然后把差异全部归因于版本。
ChatGPT、Codex和API不能只看同一个名字
ChatGPT 可能显示推理选项;Codex 可以在当前可用模型上设置任务;API 则指定模型 ID。三个入口的工具、上下文、权限和账单不同,同样写着某个家族名称,也不意味着整个使用过程相同。
只想在 ChatGPT 中选一个合适选项,可以看GPT-5.6 使用入口说明。这里重点解释怎样比较结果,而不把聊天界面按钮当成固定不变的模型清单。
按自己的任务做一组对照
选五到十个近期真正做过的任务,附上相同资料和验收标准。每个候选模型至少做两轮,记录失败原因;涉及重要业务时应增加样本,而不是用一次成功直接替换生产流程。
| 任务 | 检查什么 | 常见误判 |
|---|
| 修改代码 | 原问题消失,相关测试通过 | 代码更长就认为更完整 |
| 提取表格 | 行数、字段、金额和空值都正确 | 只看格式整齐 |
| 长文分析 | 引用能回到原文,结论覆盖约束 | 把语气肯定当成有依据 |
| 写作改写 | 事实保留,适合目标读者 | 只按辞藻多少打分 |
| 工具任务 | 工具实际执行,产出可打开 | 只看模型说“完成了” |
可以隐藏模型名称后再评分,减少对新旧版本的预期影响。若只在某一类任务上有优势,把那类任务单独分配给它,不必把所有工作都换到同一模型。
速度要算到任务真正完成
短答案最先出现,不一定总完成时间最短。还要计入遗漏后的补问、错误修复和人工核查。比如一个模型两分钟给出可用结果,另一个三十秒完成但需要四轮返工,选择可能与首字响应速度相反。
同样,更多推理不保证任何题目都更准确。测试中记录推理设置和工具权限,避免不同条件下比较。
成本也要按合格结果计算
API 可以用实际账单比较每个合格任务的成本,区分输入、缓存输入、输出及工具费用。ChatGPT 或 Codex 订阅则观察用量比例、是否打断工作和额外 Credits 支出。美元 API 单价不能直接换算成一个 Plus 账号能发几条消息。
已有 GPT-5.4 或 5.5 工作流,如果稳定达标,可以保留作为回归基线;换模型时测试相同输入、输出结构和异常处理。模型若已停止提供,应按官方弃用说明迁移,购买更高订阅不能保证恢复旧型号。
Plus和Pro怎么选
套餐决定可用权限和用量,模型决定当前任务的能力选项。两者需要分别核对。日常使用可先看Plus 商品页,持续需要更多用量再比较Pro 5x 商品页。本站人民币价格和交付规则以商品页为准。
Pro 的价格倍数不代表每个答案质量同比增加。保留自己的测试记录,再决定升级或迁移,比追着版本号反复买套餐更容易控制成本。
资料核对:2026 年 9 月 13 日。作者:我爱买号网编辑部。文中示意图用于解释流程,不是官方界面截图;产品权限、菜单与订单规则以当前页面为准。